Technische Umsetzung
Übersicht
Datenmodel
Die Forschungsdaten des Projekts Histories in Transition werden kollaborativ durch die Projektmitarbeitenden in einer relationalen Datenbank erfasst. Als Erfassungsoberfläche dient Baserow, das die strukturierte Eingabe, Verknüpfung und Verwaltung der Daten ermöglicht. Das zugrunde liegende Datenmodell wurde speziell für die Untersuchung mittelalterlicher Handschriften und ihrer Überlieferungs- und Transformationsprozesse entwickelt.
Im Zentrum des Modells stehen die Handschriften, die in kodikologische Einheiten, einzelne Texte bzw. Werkeinträge (manuscript items) und Hände untergliedert werden können. Ergänzend werden Normdaten zu Personen, Schreiber, Orten, Bibliotheken, Werken, Datierungen und Literatur in eigenen Tabellen verwaltet und über Beziehungen mit den Handschriftenobjekten verknüpft. Diese Struktur vermeidet Redundanzen und ermöglicht eine konsistente Erfassung wiederkehrender Informationen.
Öffnen Schema Darstellung.
Ein zentrales Konzept des Projekts sind die sogenannten Strata. Sie beschreiben historische Schichten innerhalb einer Handschrift, die durch bestimmte Schreib-, Bearbeitungs- oder Nutzungsvorgänge entstanden sind. Im Gegensatz zu kodikologischen Einheiten stellen Strata nicht primär materielle Schichten eines Manuskripts dar, sondern historische beziehungsweise produktionsgeschichtliche Schichten, die aus den Tätigkeiten bestimmter Hände rekonstruiert werden.
Ein Stratum wird nicht unmittelbar einer Handschrift zugewiesen, sondern über die an seiner Entstehung beteiligten Hände definiert. Die Verbindung erfolgt über die Tabellehands_role, in der dokumentiert wird, welche Hand an welchem Textabschnitt tätig war und welche Funktion sie dort ausübte. Auf dieser Grundlage können einzelne oder mehrere Hände einem gemeinsamen Stratum zugeordnet werden.
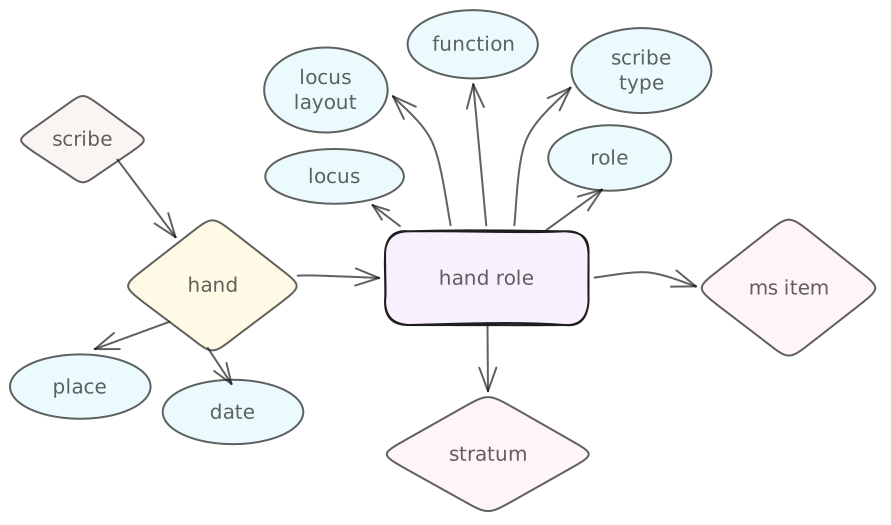
Da viele Hände paläographisch datiert und lokalisiert werden können, lassen sich diese Informationen auch auf die entsprechenden Strata übertragen. Die Strata bilden damit eine analytische Ebene zwischen den materiellen Merkmalen einer Handschrift und ihrer historischen Interpretation. Sie ermöglichen es, unterschiedliche Entstehungs-, Überarbeitungs- und Nutzungsschichten innerhalb eines Manuskripts zu modellieren und miteinander in Beziehung zu setzen.
Über die Strata hinaus erlaubt das Datenmodell die Dokumentation von Überlieferungszusammenhängen zwischen Handschriften. Mittels sogenannter Strata Filiations können Beziehungen zwischen einzelnen Schichten verschiedener Handschriften erfasst werden. Dadurch wird es möglich, Prozesse der Textübertragung, Bearbeitung und Rezeption auf einer feineren Ebene als der gesamten Handschrift zu analysieren.
Das relationale Datenmodell bildet somit die Grundlage für die Erforschung von Transformationsprozessen mittelalterlicher Wissensbestände. Es verbindet kodikologische, paläographische, textgeschichtliche und bibliographische Informationen in einer gemeinsamen Datenstruktur und schafft die Voraussetzungen für komplexe Abfragen, Visualisierungen und digitale Analysen.
Mehrstufige Erschließungstiefen
Ein wesentliches Merkmal des Datenmodells ist seine Flexibilität hinsichtlich des Erschließungsgrades einzelner Handschriften. Die Datenbank erlaubt die Erfassung von Datensätzen bereits mit einem Minimum an Informationen. Für die Aufnahme einer Handschrift genügen grundsätzlich eine Signatur sowie die Erfassung der enthaltenen Texte (msItems), auch wenn zu diesen noch keine Normdatenverknüpfungen oder weiterführenden Beschreibungen vorliegen.
Für bestimmte Funktionen der Webanwendung ist jedoch eine weitergehende Erschließung erforderlich. Insbesondere die facettierte Suche, statistische Auswertungen und Visualisierungen profitieren von der Verknüpfung der Texteinheiten mit normierten Werken und Autoren sowie von der Angabe von Datierungen. Erst diese Informationen ermöglichen es, Handschriftenbestände systematisch nach inhaltlichen, chronologischen oder geographischen Kriterien zu vergleichen.
Die detaillierte paläographische Analyse stellt eine weitere Erschließungsstufe dar. Die Beschreibung einzelner Hände, ihre Identifikation mit bekannten Schreibern sowie die Dokumentation ihrer Tätigkeiten innerhalb einer Handschrift sind nicht für jeden Datensatz erforderlich. Ebenso ist die Rekonstruktion von Strata als historischen Produktions- und Nutzungsschichten als vertiefende Analyseebene konzipiert. Das Datenmodell unterstützt diese detaillierte Erschließung, setzt sie jedoch nicht voraus und erlaubt dadurch die Aufnahme von Handschriften mit sehr unterschiedlichen Bearbeitungstiefen.
Datenverarbeitung
Die Erfassung der Forschungsdaten erfolgt kollaborativ in der relationalen Datenbank Baserow. Für die Weiterverarbeitung werden die einzelnen Tabellen regelmäßig als JSON-Dateien exportiert. Im Rahmen eines automatisierten Verarbeitungsprozesses werden sie durch eigens entwickelte TypeScript-Skripte transformiert, angereichert und miteinander verknüpft. Dabei werden insbesondere die relationalen Verbindungen zwischen den einzelnen Datensätzen aufgelöst, zusätzliche Such- und Navigationsstrukturen erzeugt sowie Daten für die Darstellung auf der Website vorbereitet.
Die so erzeugten JSON-Dateien dienen als zentrale Datengrundlage der Webanwendung. Für die wichtigsten Entitäten des Projekts – darunter Handschriften, Werke, Texteinheiten (msItems), Hände, Schreiber und Strata – werden sowohl tabellarische Übersichtsseiten als auch detaillierte Einzelansichten generiert. Die Tabellen ermöglichen eine umfassende Recherche mit Filter- und Suchfunktionen, während die Detailseiten die vollständigen Informationen eines Datensatzes sowie dessen Verknüpfungen zu anderen Objekten darstellen.
Neben klassischen Listen- und Detailansichten bietet die Anwendung zwei facettierte Suchoberflächen, die auf einem Typesense-Suchindex basieren. Die erste Suche indiziert die einzelnen Handschrifteneinträge (msItems) und ermöglicht eine gezielte Recherche nach den in den Handschriften überlieferten Werken. Die zweite Suche indiziert die rekonstruierten Überlieferungsstränge (Strata) und erlaubt die Analyse von Textüberlieferungen und deren Beziehungen. Beide Suchoberflächen unterstützen eine facettierte Filterung nach verschiedenen Metadaten, darunter Werke, Autorinnen und Autoren, Entstehungszeitraum, Entstehungsort, Gattungen bzw. Genres sowie weitere beschreibende Merkmale. Die Suchergebnisse werden in Echtzeit durch das Typesense-Backend bereitgestellt und können durch die Kombination mehrerer Facetten schrittweise eingegrenzt werden.
Die verarbeiteten Daten werden statisch in die Website integriert und bilden zugleich die Grundlage für weitere Export- und Austauschformate. Dadurch bleibt die Datenhaltung von der Präsentationsschicht getrennt und die Daten können in unterschiedlichen Kontexten nachgenutzt werden.
Kodierungsrichtlinien
Neben der Bereitstellung als JSON werden die Handschriftenbeschreibungen auch als TEI-XML-Dokumente veröffentlicht (s. Link in jeder einzelnen Handschriftbeschreibung oder eine gesamte Liste hier). Die XML-Kodierung orientiert sich am Standard der Text Encoding Initiative (TEI) und folgt dem von der Herzog August Bibliothek Wolfenbüttelentwickelten Schema für die Beschreibung mittelalterlicher Handschriften. Dadurch wird eine hohe Interoperabilität mit bestehenden digitalen Handschriftenkatalogen und Forschungsinfrastrukturen gewährleistet.
Die aus der Datenbank exportierten Informationen werden automatisiert in TEI-Strukturen überführt. Kodikologische Einheiten werden als msPart-Elemente, Texteinheiten als msItem-Elemente und Hände als eigenständige Entitäten innerhalb der Handschriftenbeschreibung modelliert.
Eine Besonderheit des Projekts ist die Modellierung der Strata. Da diese eine analytische und keine materielle Ebene repräsentieren, existiert im TEI-Standard kein unmittelbar entsprechendes Element. Die Beziehungen zwischen Händen, Texteinheiten und Strata werden daher mithilfe von Element <relation> abgebildet. Dadurch können Tätigkeiten einzelner Hände mit bestimmten Textabschnitten verknüpft und zu historischen Produktions- oder Nutzungsschichten zusammengeführt werden.
	<relation xml:id="hit_hands_role__63" active="#hit_hands__41" passive="#hit_ms_items__137">
		<desc>
			<list type="msitems">
			<item>
				<ref target="#hit_ms_items__137">Fratres de foris</ref>
			</item>
			</list>
			<locus/>
			<term type="scribe_role">Schreiber</term>
			<term type="scribe_type"/>
			<term type="function">anlegend / Anlage</term>
			<term type="locus_layout">"Schriftraum"</term>
		</desc>
	</relation>
Die Strata werden dann in Element body gelistet.
	<body>
		<div>
			<head>Strata</head>
			<list>
				<item xml:id="hit_strata__9" n="1">
					<label>Cod. 387, Stratum 1</label>
					<note type="character">Anlage</note>
					<desc/>
					<origDate notBefore="0809" notAfter="0818">809-818</origDate>
					<origPlace ref="#hit_place__3">Salzburg</origPlace>
					<list type="hand_roles">
						<item>
							<ref target="#hit_hands_role__40"/>
						</item>
					</list>
				</item>
				...
			</list>
		</div>
	</body>
Ergänzend werden die Handschriftenbeschreibungen automatisiert in LaTeX-Dokumente überführt und als PDF-Dateien bereitgestellt. Auf diese Weise stehen die Daten sowohl in einem standardisierten maschinenlesbaren Format als auch in einer für die wissenschaftliche Nutzung geeigneten Druckansicht zur Verfügung.
Quellendaten und Schnittstellen
Die rohe JSON Datei werden über das öffentliche GitHub-Repositorybereitgestellt. Die aus den rohen JSON prozesierte JSON-Dateien können in den Tabellenübersichten heruntergeladen werden (als CSV JSON oder HTML Format). Die daraus erzeugten TEI-XML-, LaTeX- und PDF-Dateien stehen in eine Tabelle zur Verfügung.
Für die automatisierte Weiterverarbeitung der Daten stellt das Projekt zudem eineOAI-PMH-Schnittstelle (Open Archives Initiative Protocol for Metadata Harvesting) bereit. Über diese standardisierte Schnittstelle können Datensätze von externen Forschungsinfrastrukturen, Bibliothekskatalogen und Aggregationsdiensten abgefragt und in andere Systeme integriert werden. Die OAI-PMH-Schnittstelle ermöglicht sowohl den Zugriff auf einzelne Datensätze als auch die Ernte größerer Datenbestände und unterstützt damit die langfristige Interoperabilität der Projektdaten.
Zur eindeutigen Identifikation und Vernetzung der erfassten Entitäten werden etablierte Normdaten- und Referenzsysteme verwendet. Personen, Autoren, Werke und Institutionen werden, soweit entsprechende Normdatensätze vorhanden sind, mit Identifikatoren derGemeinsamen Normdatei (GND) verknüpft. Ortsangaben werden über GeoNames referenziert und mit Geokoordinaten angereichert. Die bibliographischen Daten des Projekts werden in einer gemeinsamen Zotero-Bibliothek verwaltet und mit den entsprechenden Datensätzen verknüpft.
Diese Anbindung an externe Normdaten und Schnittstellen erleichtert die Nachnutzung der Daten in anderen Forschungsumgebungen und trägt zur Einbettung des Projekts in bestehende digitale Forschungsinfrastrukturen bei.
Nach Abschluss des Projekts werden die Forschungsdaten im Langzeitarchiv ARCHE (A Resource Centre for the Humanities Related Research in Austria) des Austrian Centre for Digital Humanities (ACDH) archiviert. Dadurch wird die langfristige Verfügbarkeit, Zitierbarkeit und Nachnutzbarkeit der Daten sichergestellt und ihre Einbindung in die österreichische und internationale Forschungsinfrastruktur gewährleistet.